 全部文章
Glibc Heap Exploit 坐牢笔记 - 0x01
堆相关数据结构
chunk大小问题
最小chunk大小、用户malloc申请大小和实际malloc分割出来的chunk大小的关系
众所周知,在Glibc源码中,malloc_chunk的结构体的原码如下:
struct malloc_chunk {

  INTERNAL_SIZE_T      prev_size;  /* Size of previous chunk (if free).  */
  INTERNAL_SIZE_T      size;       /* Size in bytes, including overhead. */

  struct malloc_chunk* fd;         /* double links -- used only if free. */
  struct malloc_chunk* bk;

  /* Only used for large blocks: pointer to next larger size.  */
  struct malloc_chunk* fd_nextsize; /* double links -- used only if free. */
  struct malloc_chunk* bk_nextsize;
};
这里面可以看到,如果一个chunk无论是处在allocated的状态下还是处于free状态下,他的prev_size和size这两个东西是必须存在的,而用户真正可以使用的空间是从fd那里开始的。 所以对于一个chunk,它的实际大小其实是:这个chunk对应的存储数据的大小+2*size_t=size。 但是众所周知,chunk存在下一个chunk的prev_size被复用到当前chunk里面用作存储数据。因此,我们可以算出用户实际可以使用的最大空间就是:当前chunk存储数据的空间大小+size_t=size-size_t。 但是用户申请的大小是另一个概念。 众所周知,chunk存在内存对齐的概念。下面是其在Glibc原码中的宏定义:
#ifndef MALLOC_ALIGNMENT
# if !SHLIB_COMPAT (libc, GLIBC_2_0, GLIBC_2_16)
/* This is the correct definition when there is no past ABI to constrain it.

   Among configurations with a past ABI constraint, it differs from
   2*SIZE_SZ only on powerpc32.  For the time being, changing this is
   causing more compatibility problems due to malloc_get_state and
   malloc_set_state than will returning blocks not adequately aligned for
   long double objects under -mlong-double-128.  */

#  define MALLOC_ALIGNMENT       (2 *SIZE_SZ < __alignof__ (long double)      \
                                  ? __alignof__ (long double) : 2 *SIZE_SZ)
# else
#  define MALLOC_ALIGNMENT       (2 *SIZE_SZ)
# endif
这里定义的MALLOC_ALIGNMENT就是规定了内存对齐的字节数。可以看到是2 * SIZE_SZ。这里的SIZE_SZ就是size_t,i386下是4字节,x64下是8字节。所以32位下对齐的是8字节,对应两个p32()的大小,64位下就是16字节,对应两个p64()的大小。 所以堆管理器为了节省空间,会根据用户申请的空间堆实际申请空间大小进行调整,考虑内存对齐、内存复用等因素,我们大致可以推断出以下内容: 1.当用户申请的内存小于2 * size_t的时候,就申请2 * size_t的大小的当前chunk存储数据的空间,加上内存复用的空间,实际就是可用3 * size_t的大小。 2.当用户申请的大小刚好满足 2n * size_t < 申请size <= 2n * size_t + size_t 的时候,实际上申请的当前chunk内的存储数据的空间只有 2n * size_t ,剩下的几个字节由复用的内存进行存储。 3.当用户申请的大小满足 (2n+1) * size_t < 申请的内存 < (2n+2) * size_t 的时候,实际上申请的内存是 (2n+2) * size_t 的当前chunk存储数据的空间,因为要进行内存对齐。 这里给出对应的宏进行参考:
#define request2size(req) \
(((req) + SIZE_SZ + MALLOC_ALIGN_MASK < MINSIZE) ? MINSIZE : ((req) + SIZE_SZ + MALLOC_ALIGN_MASK) & ~MALLOC_ALIGN_MASK)

#define checked_request2size(req, sz) \
if (REQUEST_OUT_OF_RANGE(req))    \
{                                 \
__set_errno(ENOMEM);          \
return 0;                     \
}                                 \
(sz) = request2size(req);
关于bins数组和bin结构的问题
我们知道,bin实际上是一个双向循环链表,bins数组将除了fastbin的bin的入口进行按照对应bin存储的chunk大小顺序进行串联,并且通过宏实现寻找对应大小bin,之后找到遍历双向循环链表的入口。
bins数组结构
我们首先看看bins数组的结构。 我们首先看看在malloc_state中bins数组的声明:
#define NBINS             128
struct malloc_chunk;
typedef struct malloc_chunk* mchunkptr;
struct malloc_state
{
... ... ... ...
  /* Normal bins packed as described above */
  mchunkptr bins[NBINS * 2 - 2];
... ... ... ...
};
可以看到bins数组申请的大小是254个mchunkptr。也就是存储127个bin,也就是127和双向循环链表的入口。此时我们大致了解到,bins数组中对应每个bin占用bins数组两个mchunkptr,即成对出现。 以下是关于bins的几个宏:
typedef struct malloc_chunk *mbinptr;

/* addressing -- note that bin_at(0) does not exist */
#define bin_at(m, i) \
  (mbinptr) (((char *) &((m)->bins[((i) - 1) * 2]))			      \
             - offsetof (struct malloc_chunk, fd))
这里的m就是malloc_state,i就是要查找的对应bin的下标(这里的下标并不是bins数组下标,在这里就得到了体现。)
bins中bin的存储与访问
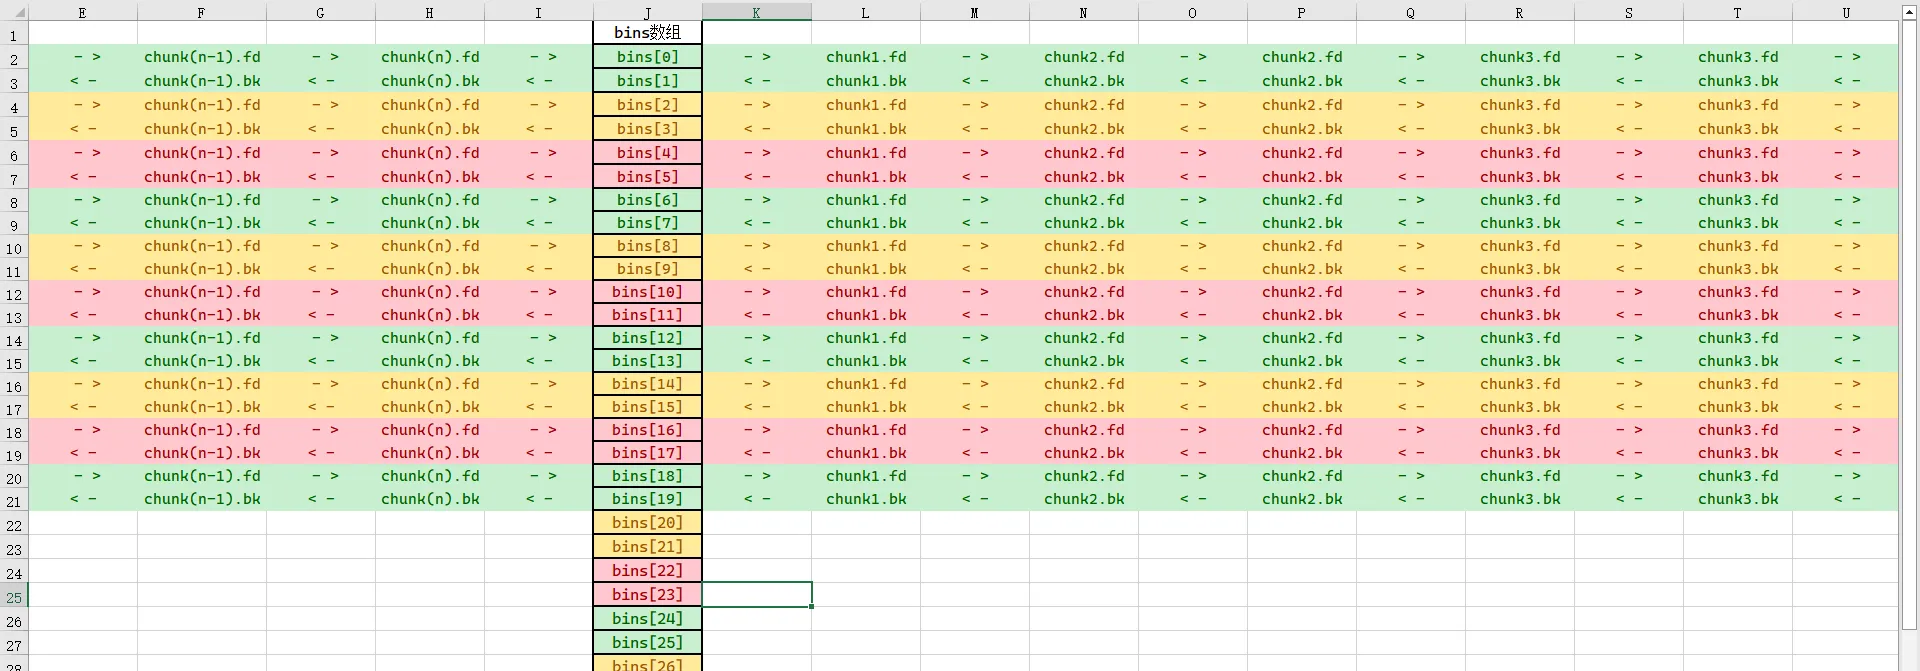
我们可以看到,bin_at尝试去寻找bin的时候,取到的下标永远是偶数,因此我们可以知道,bin在bins数组里面是连续相邻成对出现的。即:
bin[0],bin[1]是一个bin
bin[2],bin[3]是一个bin
bin[4],bin[5]是一个bin
,当然这里bins数组存储的只是每个bin的入口,或者可以说是末尾,毕竟是双向循环链表。
我们知道,一个bin的双向循环链表的开头是一个front(是一个chunk),这个front对应的就是bins数组那一对。为了节省空间,这里front仅仅保留了fd、bk这两个元素,对应的就是bins[2n]、bins[2n+1]。
用图表画出来就是:
 :::primary
注意这里的指针并不是图中显示的那样。
实际上,这里的每一个fd都连接到下一个chunk的开头,即prev_size那里。同样所有的bk都是连接到前一个chunk的prev_size那里。
具体可以自己写几个chunk试验一下。
:::
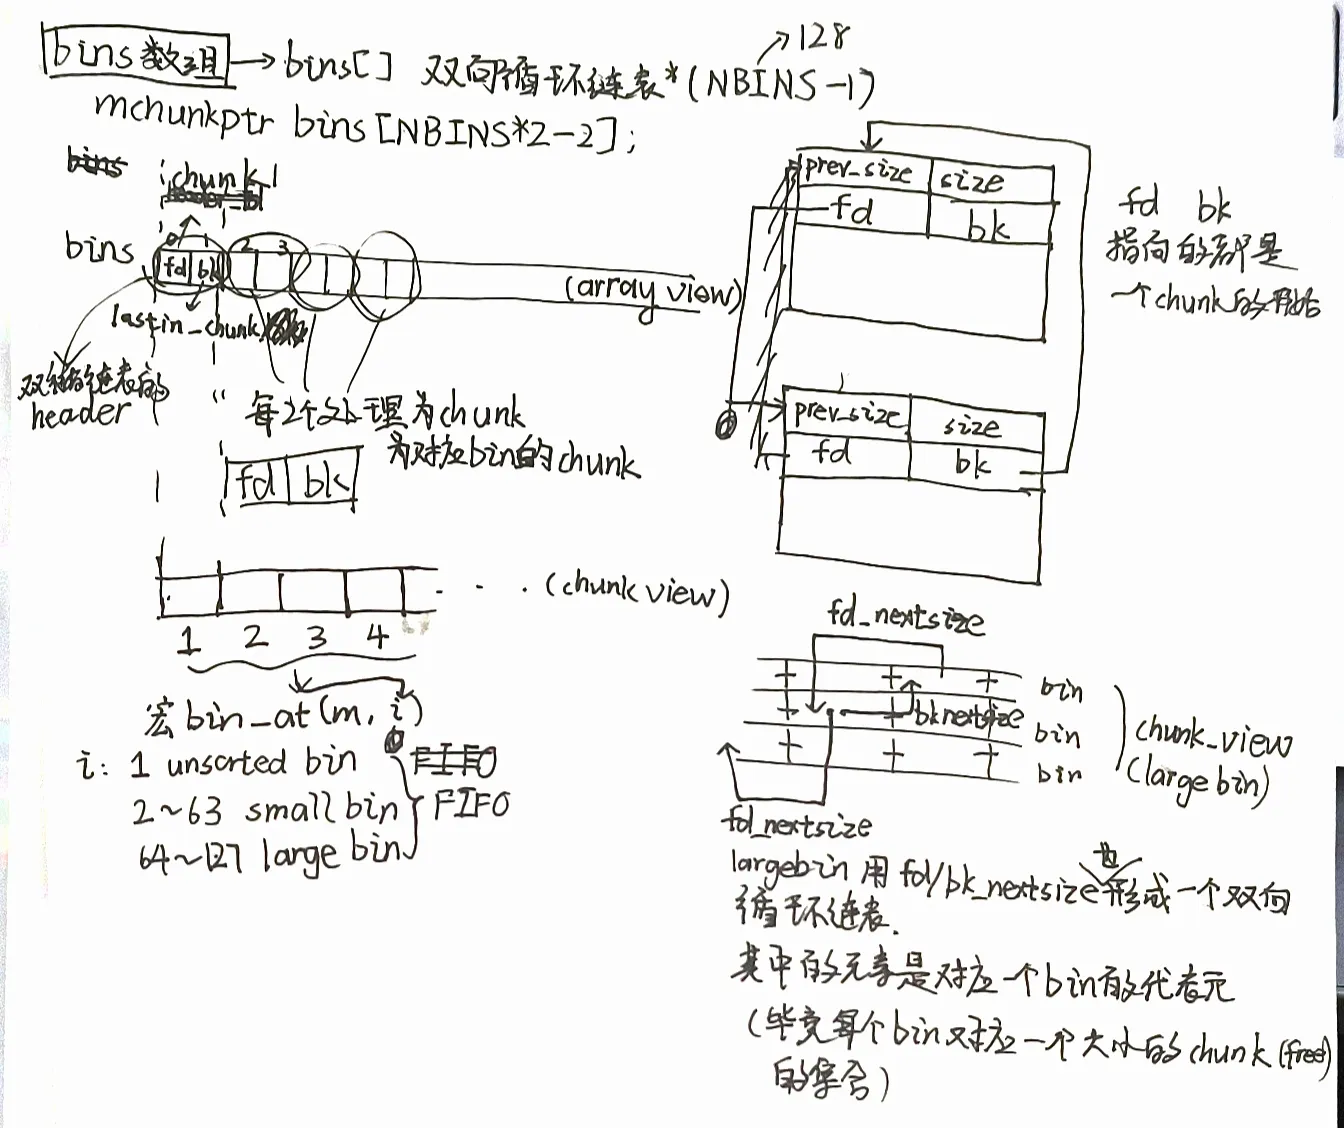
bins数组中的bin有三种类型:unsortedbin,smallbin,largebin,他们对应的位置是: 第 1 个 :unsorted bin 第 2 ~ 63 个:small bin 第 64 ~ 127 个:large bin
largebin独自的双向循环链表
这里只有largebin启用了fd_nextsize,bk_nextsize这两个元素,具体连接方式: largebin每个bin选出对应大小的代表元,这些代表元用fd_nextsize,bk_nextsize连成一个双向循环链表。
bins数组总结
这里总结一下bins数组:
fastbin
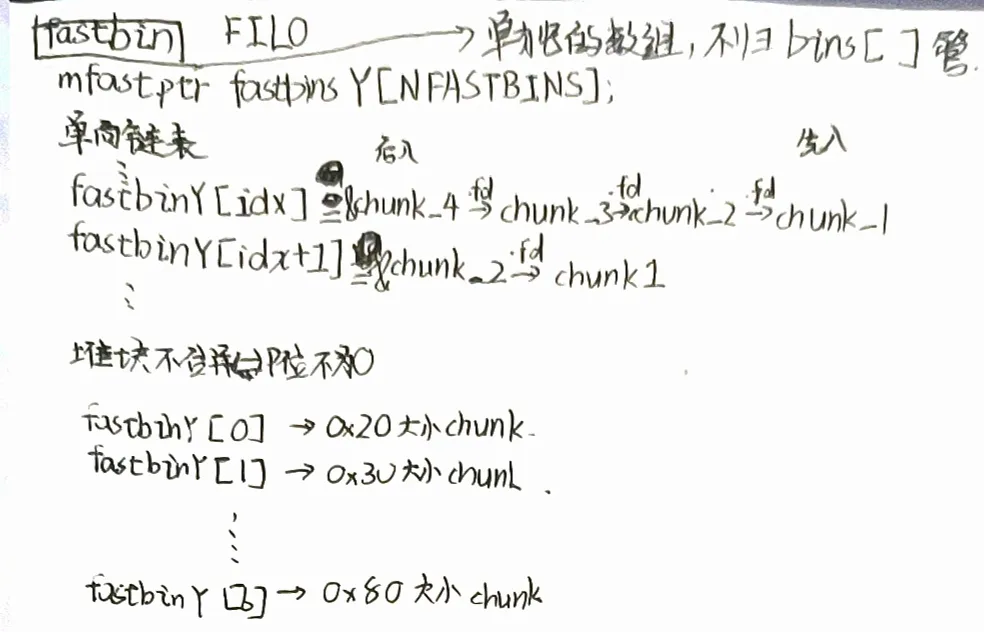
说了bins,顺便该说说不存在于bins数组的bin---fastbin(虽然这个挺好理解的) 结构就是相当于单向链表版本的bins数组,malloc_state中的定义就是:
typedef struct malloc_chunk *mfastbinptr;
#define fastbin(ar_ptr, idx) ((ar_ptr)->fastbinsY[idx])

/* offset 2 to use otherwise unindexable first 2 bins */
#define fastbin_index(sz) \
  ((((unsigned int) (sz)) >> (SIZE_SZ == 8 ? 4 : 3)) - 2)


/* The maximum fastbin request size we support */
#define MAX_FAST_SIZE     (80 * SIZE_SZ / 4)

#define NFASTBINS  (fastbin_index (request2size (MAX_FAST_SIZE)) + 1)

struct malloc_state
{
... ... ... ...
  /* Fastbins */
  mfastbinptr fastbinsY[NFASTBINS];
... ... ... ...
};
直接放个图就啥都明白了,这个没啥难度。
Conclusion
这篇笔记着重澄清了bins数组和bin之间的关系以及存储结构等内容,顺便写了一下fastbin的结构。 这部分内容对于部分Glibc教程来说基本上写的不是不详细就是不易理解。这里仅仅作为本人理解的内容,如有错误,速速指出!!!!!!!。
ByeBye ༼ つ ◕_◕ ༽つ
༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕◕ ༽つ༼ つ ◕_◕ ༽つ